 Marcin Golonka
Wprowadzenie
Dziś decyzję „czy zablokować tę ofertę dostawcy” podejmuje człowiek, patrząc na reklamację i historię sprzedaży. Sprawdziłem, czy taką decyzję da się powierzyć małemu, tanio uruchamianemu modelowi – bez utraty jakości decyzji.
Impulsem dla mnie był fakt, że model decyzyjny oparty na Bieliku – basal – zajął pierwsze miejsce w benchmarku dla modeli decyzyjnych. Postanowiłem przetestować go w bardziej biznesowym kontekście, stawiając pytanie: „Czy oferta X powinna zostać wyłączona, bo jest wadliwa?”.
Co siedzi w środku?
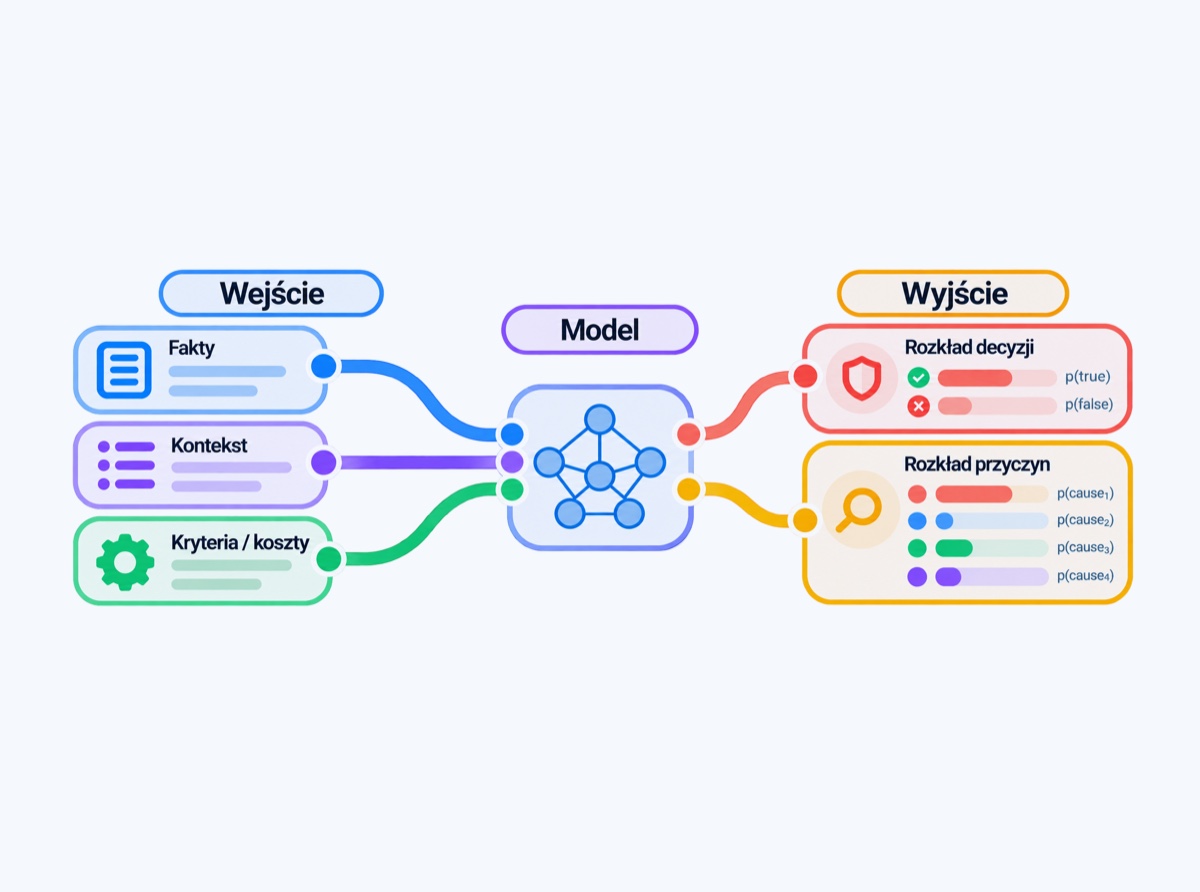
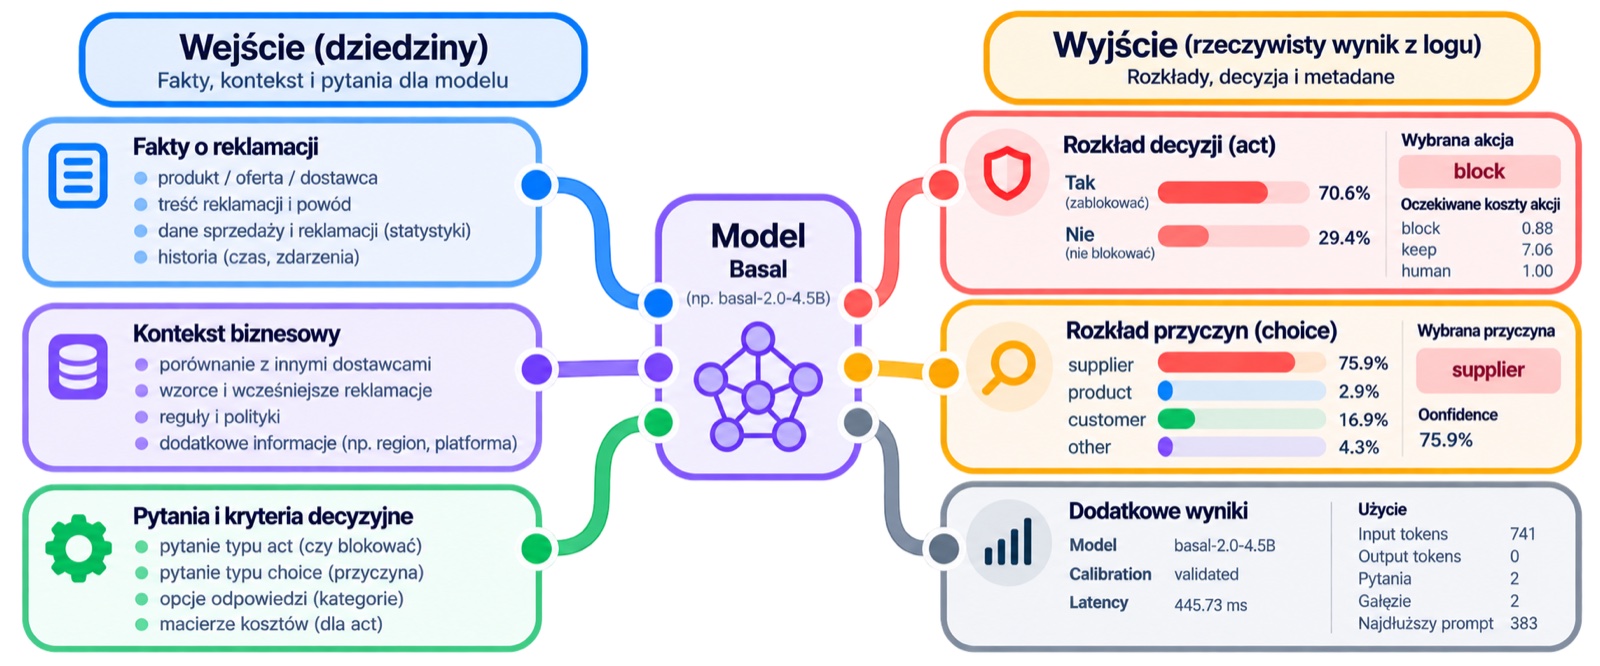
Modele decyzyjne oceniają kontekst sytuacji wykreowany jako wejście (dowody), produkując na wyjściu: decyzję, rozkład prawdopodobieństwa lub scoring decyzji. Co do zasady modele decyzyjne podejmują decyzję „tu i teraz” – nie posiadają mechanizmu pamięci, nie odwołują się do narzędzi zewnętrznych. Opierają się w stu procentach na wykreowanym obrazie (kontekście) i macierzy możliwych do podjęcia decyzji.
Nasz przypadek: kat czy łaska dla oferty dostawcy
U jednego z naszych klientów – sklepu internetowego z produktami cyfrowymi, który ten sam produkt kupuje od wielu dostawców – jednym z problemów, z którymi walczymy, jest wadliwość ofert od dostawców. Przyczyny są różne – błąd człowieka w mapowaniu, brak lub błędne dane od dostawcy (np. region), a często po prostu dostarczona nam partia jest wadliwa.
Celem jest sprawdzić, czy model decyzyjny w oparciu o przedstawione dowody jest w stanie podjąć decyzję o zdjęciu konkretnej oferty ze sprzedaży.
Pokaż mi dowód!
By model mógł podjąć w jego ocenie najlepszą decyzję, trzeba wyposażyć jego kontekst w informacje. W przypadku pytania „Czy oferta X powinna zostać wyłączona, bo jest wadliwa?” zestaw cech, które ująłem w kontekście, to:
- Oferta
- dostawca: nazwa, sub-sprzedawca i ID oferty dostawcy
- nazwa produktu
- Reklamacja, która uruchamia decyzję
- data i godzina wpłynięcia
- powód
- treść
- Sprzedaż tej oferty w ostatnich 24h
- sprzedane sztuki
- liczba reklamacji
- wskaźnik reklamacji (%)
- Ten sam produkt u innych dostawców w ostatnich 24h
- sprzedane sztuki
- liczba reklamacji
- wskaźnik reklamacji (%)
- Historia oferty dzień po dniu (ostatnie 7 dni, dni bez ruchu pominięte)
- sprzedane sztuki (transakcje zakończone)
- nieudane zakupy u dostawcy
- liczba reklamacji
- Wcześniejsze reklamacje tej oferty z tych 7 dni
- liczba
- dla każdej (maks. 8): data, powód i treść (do 400 znaków)
Docelowo kontekst, który trafia do modelu, wygląda tak (przykład zanonimizowany – dostawca, produkt, treść reklamacji i daty są zmienione, struktura jest 1:1):
Oferta: dostawca Dostawca B/Sprzedawca 07 #OF-10482, produkt Software Subscription - 3 Months - GLOBAL.
Nowa reklamacja (2026-10-14 11:20+00:00), powód: invalid. Treść: code not working
Sprzedaż tej oferty w ostatnich 24h: 1 szt., reklamacji: 1 (100.0%).
Ten sam produkt u innych dostawców w 24h: 0 szt., reklamacji: 1 (brak sprzedaży).
Historia tej oferty z ostatnich 7 dni (dni bez ruchu pominięte):
- 2026-10-14: sprzedane 1, nieudane zakupy u dostawcy 0, reklamacje 1
Wcześniejsze reklamacje tej oferty z tego okresu (0):
Tak dobrany zestaw cech daje modelowi jasność sytuacji oraz porównanie się z konkurencyjnymi ofertami, szczególnie na produktach „ruchliwych”.
Pokaż mięso!
Na potrzeby testu rozważyłem 3 metody odpowiedzi na tezę postawioną na początku artykułu:
- wywołanie modelu z kontekstem określonym w rozdziale wyżej,
- wywołanie modelu bez zbudowanego kontekstu – ocena tylko zaistniałej sytuacji,
- prosta heurystyka – 3 zgłoszenia reklamacyjne z rzędu w ciągu 24h (okno kroczące) – ban.
Ponieważ działałem retrospektywnie, można było się pokusić o doposażenie kontekstu w całość informacji, nawet o zdarzenia, które zdarzyły się po złożeniu reklamacji, lecz nie odzwierciedlałoby to realnej sytuacji.
Więc metoda testowa zakładała wywoływanie modelu decyzyjnego w czasie wpłynięcia zgłoszenia reklamacyjnego (t) i zasilenie go danymi historycznymi sprzed czasu t. Czyli model, mimo że wywołujemy go post factum, nie wie o wydarzeniach z przyszłości.
Próbka badawcza wynosiła ostatnie 300 reklamacji, z czego 170 z nich dotyczyło wcześniejszej reklamacji oferty.
Ile boli pomyłka?
By model podjął właściwą decyzję, musimy zasilić go tzw. macierzą strat. Określa ona, jak bardzo bolesne są dla nas konkretne decyzje, gdy model się myli lub gdy ma rację. Jest ona elementem regulacji apetytu biznesu na ryzyko.
Na potrzeby naszego scenariusza założyłem 3 klasy kosztów:
| akcja | oferta naprawdę zła ("true") | oferta naprawdę dobra ("false") |
|---|---|---|
block – Zablokuj ofertę | 0: słuszna blokada | 3: niepotrzebna blokada, tracimy sprzedaż do odblokowania |
keep – Zostaw ofertę w sprzedaży | 10: zła oferta sprzedaje dalej, więc refundy, praca supportu i oceny na marketplace są dla nas największym bólem | 0: słusznie zostawiona |
human – Daj zdecydować człowiekowi | 1: koszt przeglądu przez człowieka jest mało uciążliwy | 1: to samo, przegląd kosztuje niezależnie od wyniku |
Wiersze to akcje, które możemy podjąć; kolumny to to, jak naprawdę jest z ofertą, czego w chwili decyzji nie wiemy. Każda komórka mówi, ile tracimy, jeśli podejmiemy daną akcję.
Ponieważ jednostka jest umowna, założyłem skalę 0–10.
Wyniki
Poniżej widać rozkład decyzji (block / keep / human) podjętych przez każdą z 3 metod na wszystkich 300 przypadkach:
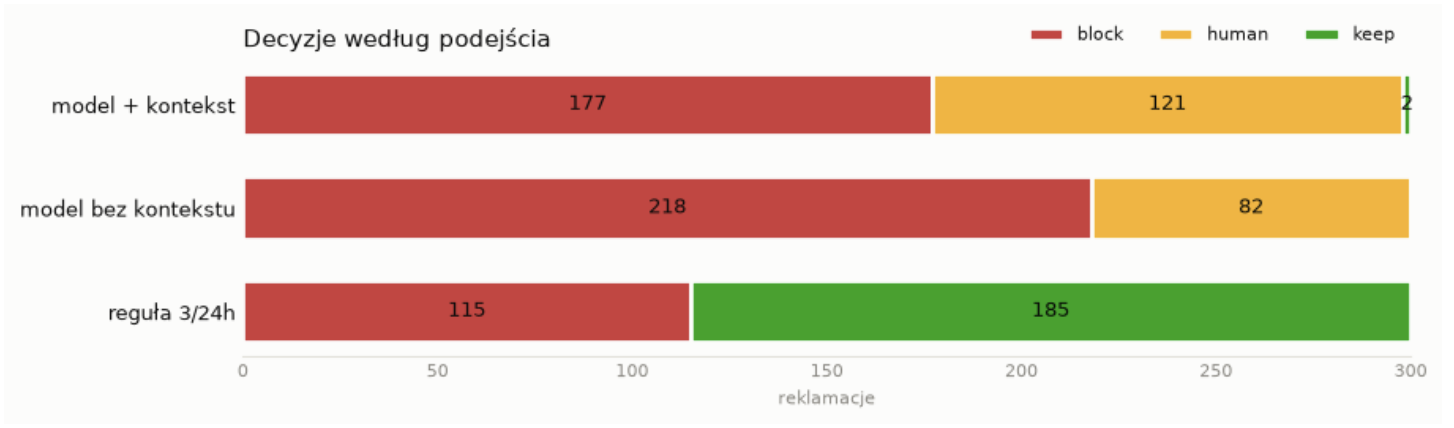
Jak łatwo zauważyć, kontekst zdecydowanie łagodzi agresywność modelu w podejmowaniu decyzji o blokadzie, co dowodzi, że kluczowym procesem we wdrożeniu produkcyjnym będzie etap inżynierii cech.
Najłagodniej wypada prosta heurystyka – ewidentnie brak członu analitycznego nie pozwala podjąć agresywnej decyzji, jeżeli nie wystąpi prawo serii.
Sprzęt
Ponieważ model jest self-hosted, uruchomiłem go na dwóch sprzętach, które miałem pod ręką:
| Parametr | PC z NVIDIA RTX 3060 | MacBook Air M1 |
|---|---|---|
| Procesor | AMD Ryzen 5 8400F | Apple M1, 8 rdzeni CPU (4 wydajne + 4 energooszczędne) |
| GPU | NVIDIA GeForce RTX 3060, 12 GB VRAM | Apple M1, 8 rdzeni GPU (zintegrowane) |
| RAM | 32 GB | 16 GB (pamięć współdzielona CPU i GPU) |
| System | Ubuntu 25.10 | macOS 27.0 |
| Model | basal-2.0 4.5B | basal-2.0 4.5B, port MLX |
| Precyzja wag | bf16, ok. 9 GB | 8-bit, ok. 5 GB |
| Silnik basal | 2.3.1 | 2.1.0 |
| Python | 3.12 | 3.12 |
| Średni czas ewaluacji jednego scenariusza | ~450 ms | ~730 ms |
Jak widać, model działa szybko – zdecydowanie szybciej niż dowolny LLM. Dzięki temu koszty ewaluacji są relatywnie małe. Model można też odpalić na znanych runnerach modeli w sieci, na przykład Hugging Face.
Wnioski
Zdecydowanie jest to gałąź, którą warto eksplorować. Koszty wdrożenia oraz przewidywalność rozwiązania pokazują obiecujący potencjał tej metody podejmowania decyzji przy odcinaniu niepewnych ofert. Kluczem przy wdrożeniu będzie zbudowanie dobrych cech i opakowanie ich w kontekst, by model mógł posiadać możliwie jak najszerszą wiedzę przy podejmowaniu decyzji.
Źródła
- basal.si5.pl – strona modelu basal
- JevBench v1 – benchmarkheaven.com/jev-models – ranking i opis benchmarku modeli decyzyjnych (typed decision accuracy, calibration, latency, cost)
- fstandhartinger/jevbench na GitHubie – kod i metodyka benchmarku JevBench
- benchmarkheaven/jevbench na Hugging Face – zbiór danych benchmarku
- rkinas/basal na GitHubie – licencja i autorstwo modelu (Remigiusz Kinas, współtwórca Bielika)
- Cost-loss model – Wikipedia – teoretyczne podstawy decyzji opartych o macierz kosztów
- The Foundations of Cost-Sensitive Learning (Elkan) – klasyczna praca o uczeniu z macierzą kosztów
- Prawo serii
Surowy request i odpowiedź modelu
Ten sam zanonimizowany przykład co wyżej. Odpowiedź pochodzi z oryginalnego wywołania, sprzed podmiany nazw i treści.
Request – POST http://localhost:8000/v1/systemone:
{
  "state": "Oferta: dostawca Dostawca B/Sprzedawca 07 #OF-10482, produkt Software Subscription - 3 Months - GLOBAL.\nNowa reklamacja (2026-10-14 11:20+00:00), powód: invalid. Treść: code not working\nSprzedaż tej oferty w ostatnich 24h: 1 szt., reklamacji: 1 (100.0%).\nTen sam produkt u innych dostawców w 24h: 0 szt., reklamacji: 1 (brak sprzedaży).\nHistoria tej oferty z ostatnich 7 dni (dni bez ruchu pominięte):\n- 2026-10-14: sprzedane 1, nieudane zakupy u dostawcy 0, reklamacje 1\nWcześniejsze reklamacje tej oferty z tego okresu (0):",
  "questions": {
    "block": {
      "type": "act",
      "instructions": "Czy oferta dostawcy Dostawca B/Sprzedawca 07 #OF-10482 dla produktu Software Subscription - 3 Months - GLOBAL jest wadliwa (dostawca dostarcza niedziałające, użyte lub złe regionowo kody) i trzeba ją zablokować?",
      "criteria": {
        "true": "Tak, problem leży po stronie tego dostawcy",
        "false": "Nie, to pojedynczy przypadek, błąd klienta albo problem całego produktu"
      },
      "costs": {
        "block": { "true": 0, "false": 3 },
        "keep": { "true": 10, "false": 0 },
        "human": { "true": 1, "false": 1 }
      }
    },
    "cause": {
      "type": "choice",
      "instructions": "Jaka jest najbardziej prawdopodobna przyczyna reklamacji?",
      "criteria": {
        "supplier": "Wadliwe kody od tego dostawcy (nieważne, użyte, zły region)",
        "product": "Problem całego produktu, występuje też u innych dostawców",
        "customer": "Błąd klienta (zła platforma, konto, region klienta)",
        "other": "Inne (dostawa, płatność, pytanie)"
      }
    }
  }
}
Odpowiedź:
{
  "model": "basal-2.0-4.5B",
  "answers": {
    "block": {
      "type": "act",
      "action": "block",
      "expected_costs": {
        "block": 0.880595,
        "keep": 7.064682,
        "human": 1.0
      },
      "answer": "true",
      "probabilities": {
        "true": 0.7064682245254517,
        "false": 0.29353171586990356
      },
      "confidence": 0.7064682245254517,
      "calibration": "validated"
    },
    "cause": {
      "type": "choice",
      "choice": "supplier",
      "probabilities": {
        "supplier": 0.7587137818336487,
        "product": 0.029148070141673088,
        "customer": 0.1687118411064148,
        "other": 0.04342631623148918
      },
      "confidence": 0.7587137818336487
    }
  },
  "usage": {
    "input_tokens": 741,
    "output_tokens": 0,
    "questions": 2,
    "branches": 2,
    "latency_ms": 445.73,
    "longest_prompt_tokens": 383
  }
}